UK
 Ігор Ніколенко
Кожен промпт, який ви надсилаєте мовній моделі, оплачується токенами. І значну частину цих токенів модель витрачає на обгортку: лапки, двокрапки, фігурні дужки, повторення назв полів у кожному записі. Коли ви передаєте в LLM один запис, це непомітно. Коли автоматизація щогодини вантажить у промпт сотні рядків із CRM або таблиці, обгортка починає коштувати більше, ніж самі дані.
Саме зараз це стало важливим, бо автоматизації з ШІ перестали бути експериментом. У n8n, у агентних системах, у RAG-пайплайнах дані ганяють між кроками десятки разів на день, і за кожен крок ви окремо платите за токени. Плюс контекстне вікно: чим більше місця займає обгортка, тим менше лишається на сенс, і модель починає «забувати» початок розмови.
У цій статті я розберу TOON (Token-Oriented Object Notation), формат, який придумали саме для того, щоб LLM читала ті самі дані компактніше. Що це таке, як виглядає поруч із JSON, де економія справжня, а де її не буде, і як вбудувати TOON у свою автоматизацію без переписування всієї системи.
Що таке TOON і чим він відрізняється від YAML
Перша реакція у більшості: «Знову якийсь формат? У нас уже є JSON, YAML, TOML, CSV, Protocol Buffers». Різниця в адресаті. JSON придумали для обміну між програмами, YAML для конфігів, які читає людина. TOON придумали для читача, який думає токенами. Читабельність і строгі схеми тут на другому плані. Мета одна: модель має побачити структуру даних, витративши на неї мінімум токенів, і при цьому не заплутатись.
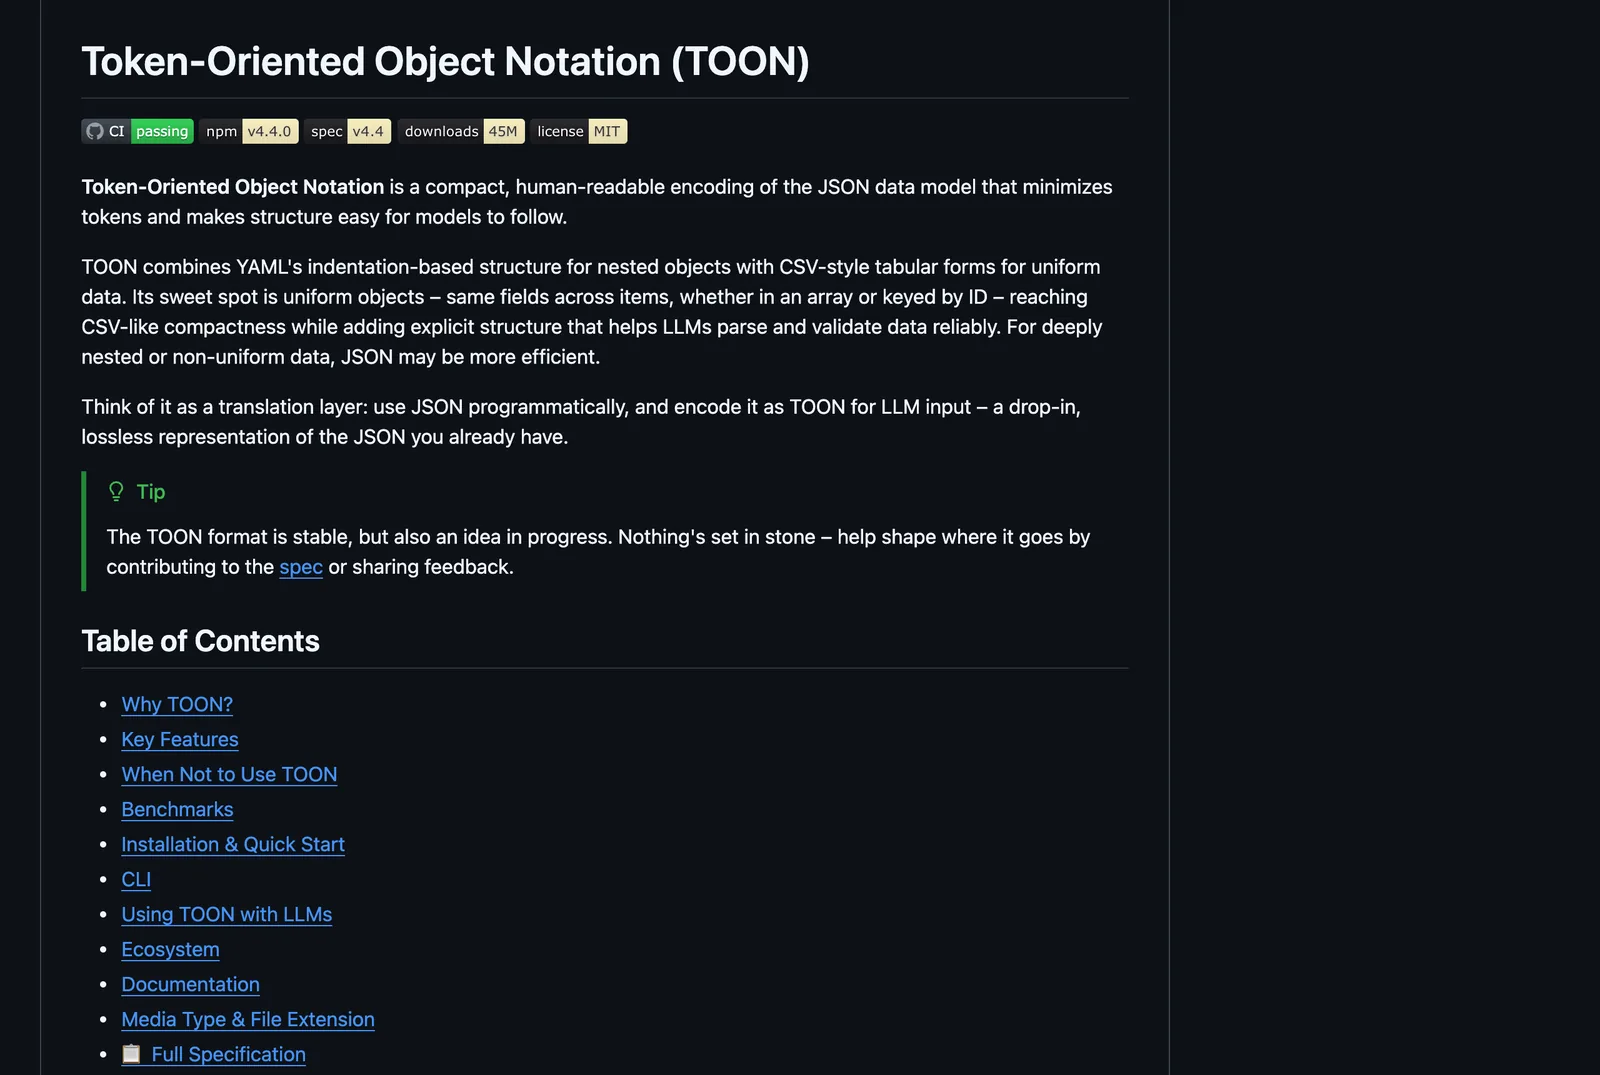
Ідея проста до незручності. Якщо у вас масив однакових обʼєктів, скажімо, тисяча замовлень з однаковими полями, JSON повторить назви цих полів тисячу разів. TOON пише назви полів один раз, у заголовку, а далі йдуть тільки значення, рядок за рядком, через роздільник. Приблизно так, як виглядає таблиця, коли її описати текстом.
Ще дві речі, які відрізняють TOON від простого CSV. По-перше, у заголовку масиву стоїть кількість рядків у квадратних дужках. Модель бачить, скільки записів має бути, і це працює як вбудована перевірка: якщо рядків менше або більше, щось загубилось. По-друге, TOON уміє описувати вкладені структури через відступи, як YAML, тому не обмежується плоскими таблицями.
Як виглядає TOON поруч із JSON
Візьмемо три користувачі з полями ідентифікатора, імені та міста. У JSON це буде масив із трьох обʼєктів, у кожному з яких тричі повторяться назви полів, лапки навколо кожного рядкового значення, дужки й коми. У TOON той самий набір даних виглядає так (рядки зі значеннями пишуться з відступом під заголовком):
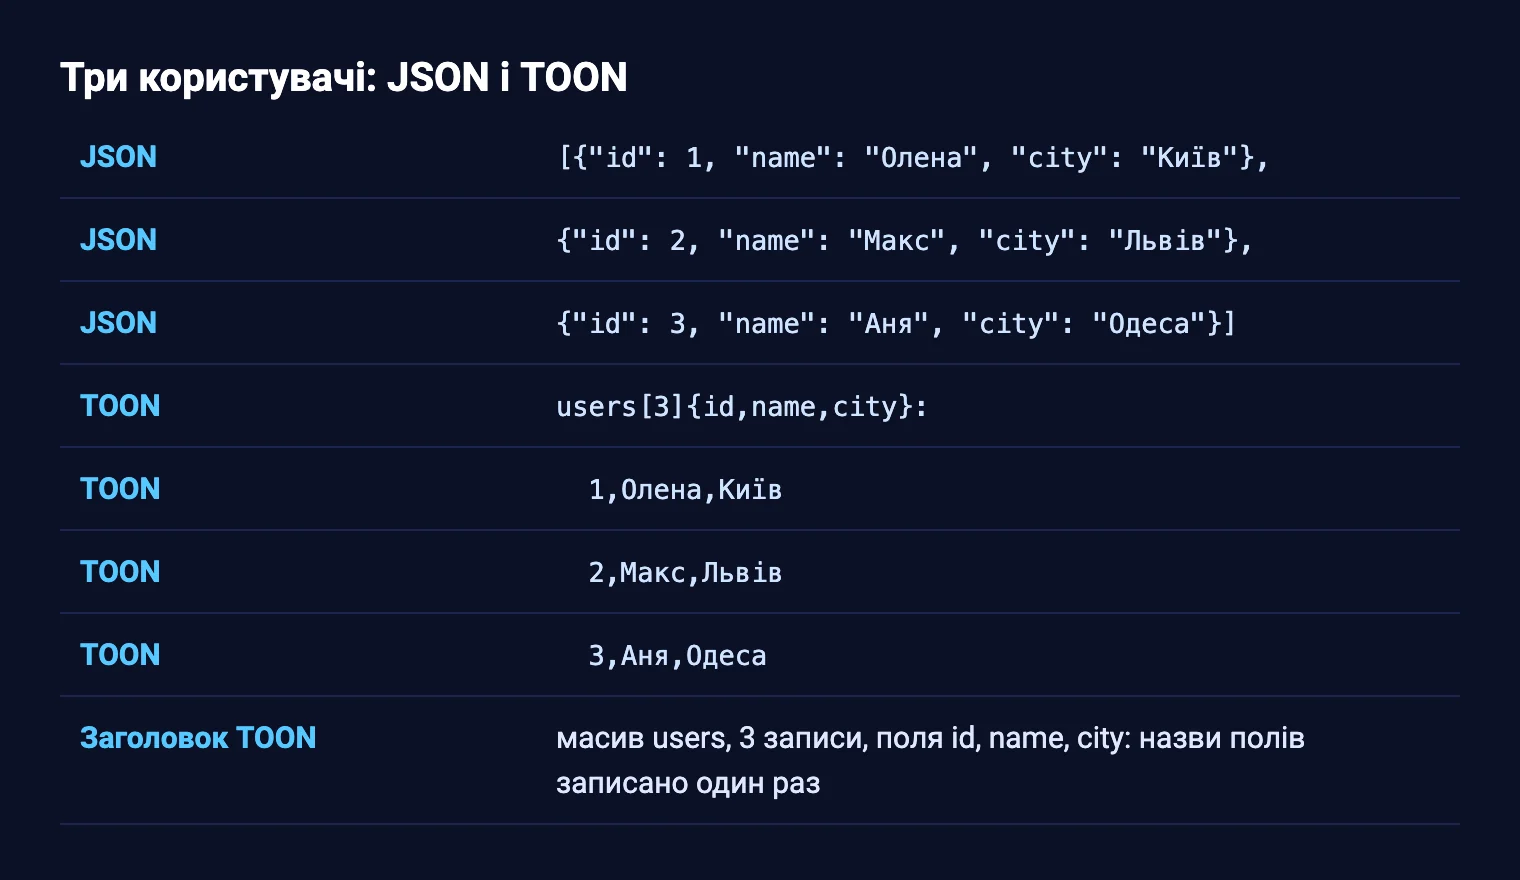
users[3]{id,name,city}:
1,Олена,Київ
2,Макс,Львів
3,Аня,Одеса
Заголовок читається так: масив users, у ньому 3 записи, у кожного поля id, name, city. Далі йдуть самі значення. Лапки не потрібні, поки значення не містить роздільника або спецсимволів; тоді його беруть у лапки, як у CSV.
Простий обʼєкт без масиву записується парами «ключ: значення», кожна з нового рядка. Масив примітивів пишуть одним рядком: назва, кількість у дужках, двокрапка і значення через кому. Вкладені обʼєкти йдуть через відступ під батьківським ключем. Тобто вся структура, яку ви звикли бачити в JSON, є і тут, просто без символів, які модель мала б «прочитати й проігнорувати».
Важлива деталь: роздільник між значеннями в табличній частині не обовʼязково кома. Специфікація дозволяє табуляцію або вертикальну риску, і це рятує, коли у вас дані з текстами, де коми на кожному кроці: описи товарів, адреси, коментарі. Змінили роздільник, і не треба брати в лапки половину значень.
Де економія справжня, а де її не буде
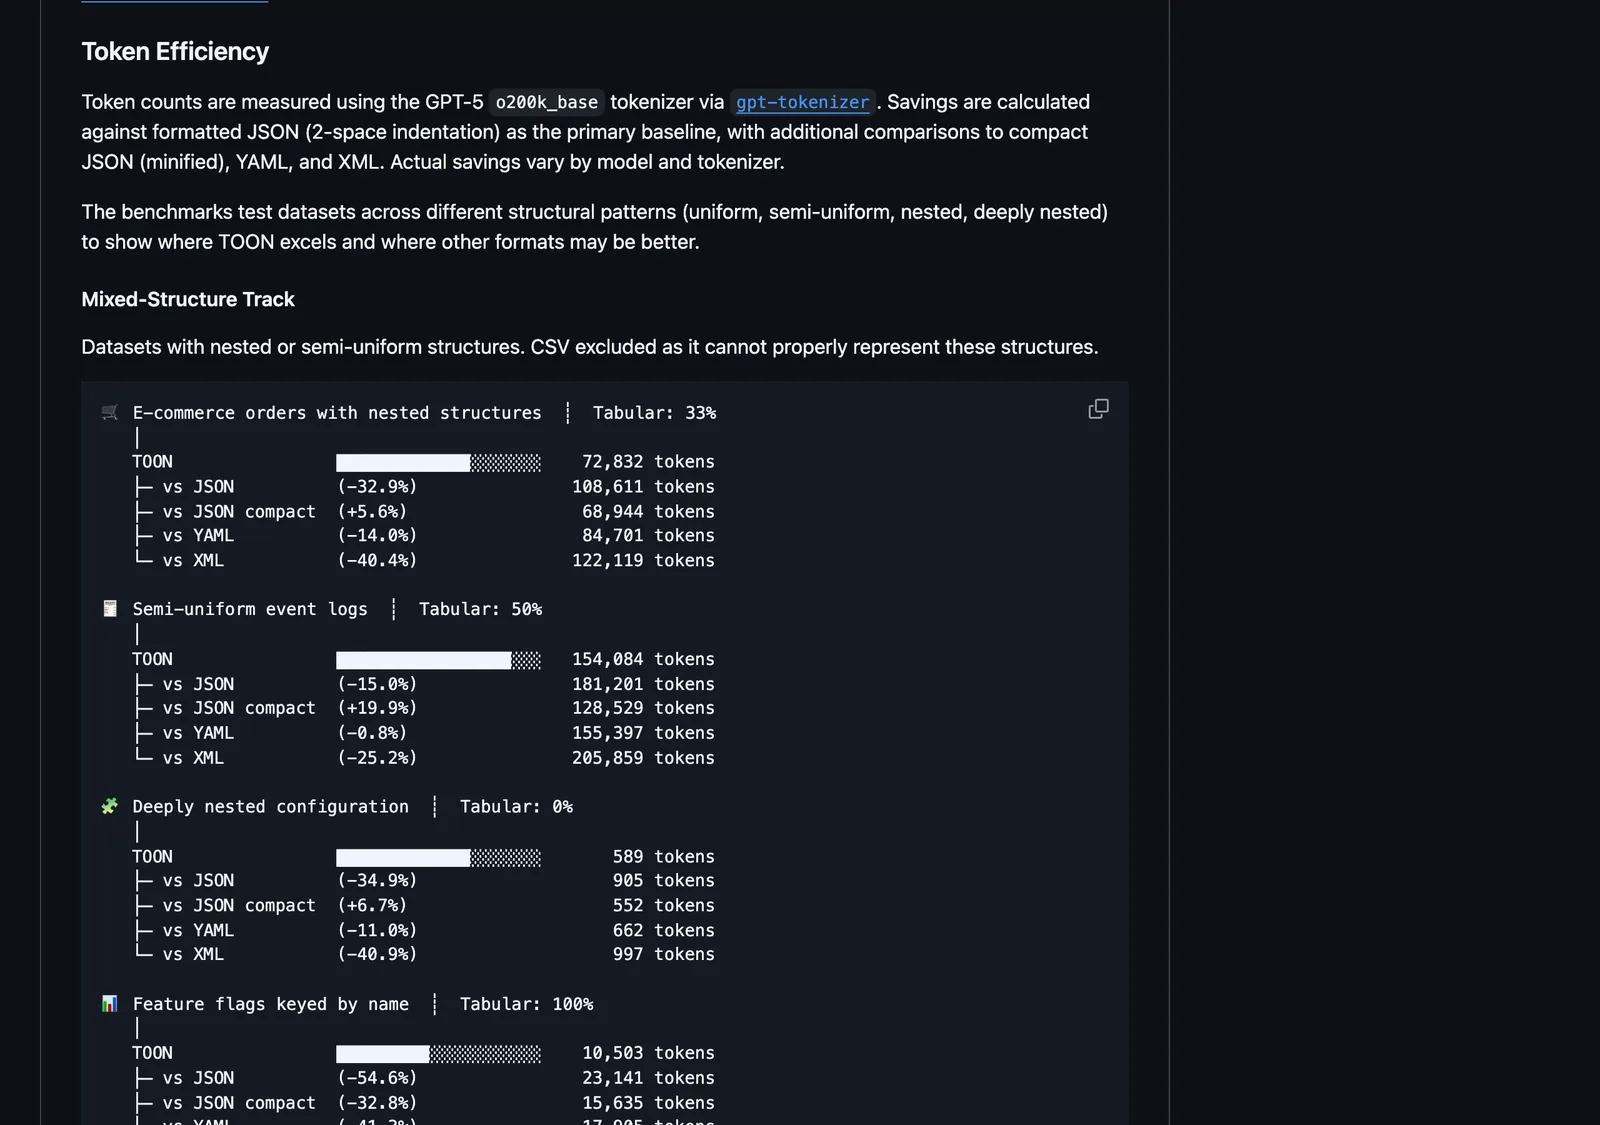
Навколо TOON уже встигли зʼявитись обіцянки з великими відсотками, тому почну з обмежень. Автор формату публікує власні бенчмарки у репозиторії, і вони показують суттєве зменшення кількості токенів проти JSON на табличних даних. Але ваш результат залежить від форми ваших даних, і ось як це працює на практиці.
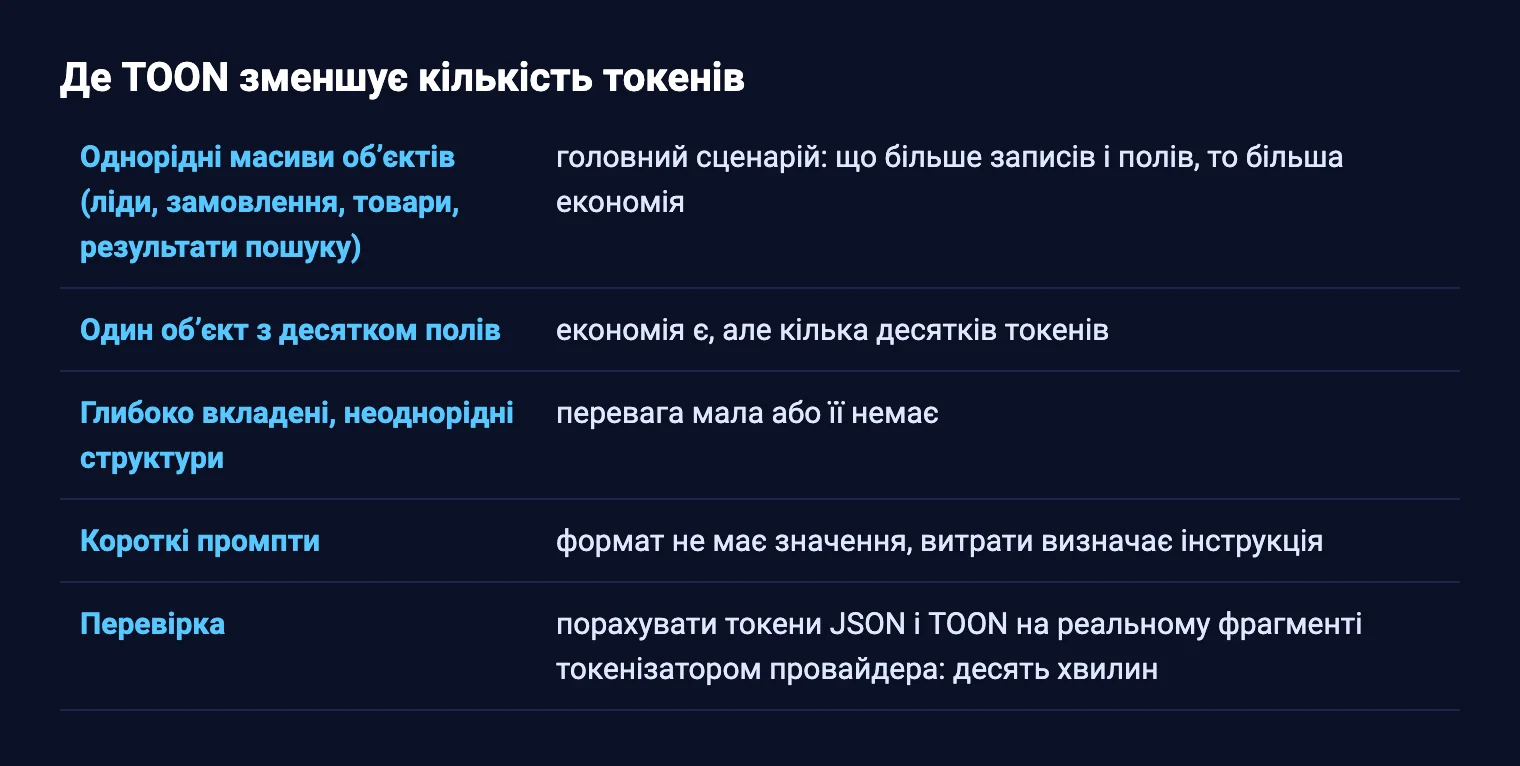
- Однорідні масиви обʼєктів: головний сценарій. Список замовлень, лідів, товарів, рядків звіту, результатів пошуку. Що більше записів і що більше полів у кожному, то більша економія, бо саме тут JSON найбільше повторюється.
- Один обʼєкт з десятком полів: економія є, але невелика. Обгортки мало, повторів немає, різниця в кілька десятків токенів. Заради цього переписувати промпт не варто.
- Глибоко вкладені, неоднорідні структури, коли в кожного запису свій набір полів або вкладені масиви різної довжини. TOON тут працює, але перевага над JSON стає малою, а іноді її немає взагалі. Це прямо написано і в документації формату.
- Короткі промпти. Якщо даних на два рядки, формат не має значення. Витрати визначає інструкція, а не дані.
Найпростіший спосіб не гадати: виміряти. Візьміть реальний фрагмент даних, який зараз іде у промпт, порахуйте токени у форматі JSON і в TOON через токенізатор вашого провайдера, і подивіться на різницю. У мене на списках лідів і результатах пошуку різниця була помітною, на одиночних картках її не було. Це десять хвилин, які збережуть вас від переписування там, де воно не окупиться.
TOON, JSON, YAML і CSV: хто для чого
| Критерій | JSON | YAML | CSV | TOON |
|---|---|---|---|---|
| Для кого створений | Програми | Людина (конфіги) | Таблиці | Мовні моделі |
| Повтор назв полів | У кожному записі | У кожному записі | Один раз | Один раз |
| Вкладені структури | Так | Так | Ні | Так, через відступи |
| Вбудована перевірка кількості | Ні | Ні | Ні | Так, лічильник у заголовку |
| Екосистема й підтримка в API | Всюди | Широка | Широка | Молода, бібліотеки є |
| Де тримати як канонічний формат | Так | Так | Для плоских даних | Ні, лише для промптів |
Головний висновок із таблиці в останньому рядку. TOON не заміняє JSON у базі, в API чи в файлах конфігурації. Його місце одне: межа між вашою системою й моделлю. Дані зберігаються як зберігались, конвертуються в TOON перед тим, як потрапити в промпт, і за потреби розконвертовуються назад після відповіді.
Як вбудувати TOON в автоматизацію
Специфікація формату й офіційна реалізація лежать у відкритому репозиторії toon-format/toon на GitHub. Там є бібліотека для JavaScript і TypeScript, консольна утиліта для конвертації та посилання на реалізації іншими мовами від спільноти. Далі схема, яку я використовую в n8n, але вона така сама для будь-якого оркестратора чи власного коду.
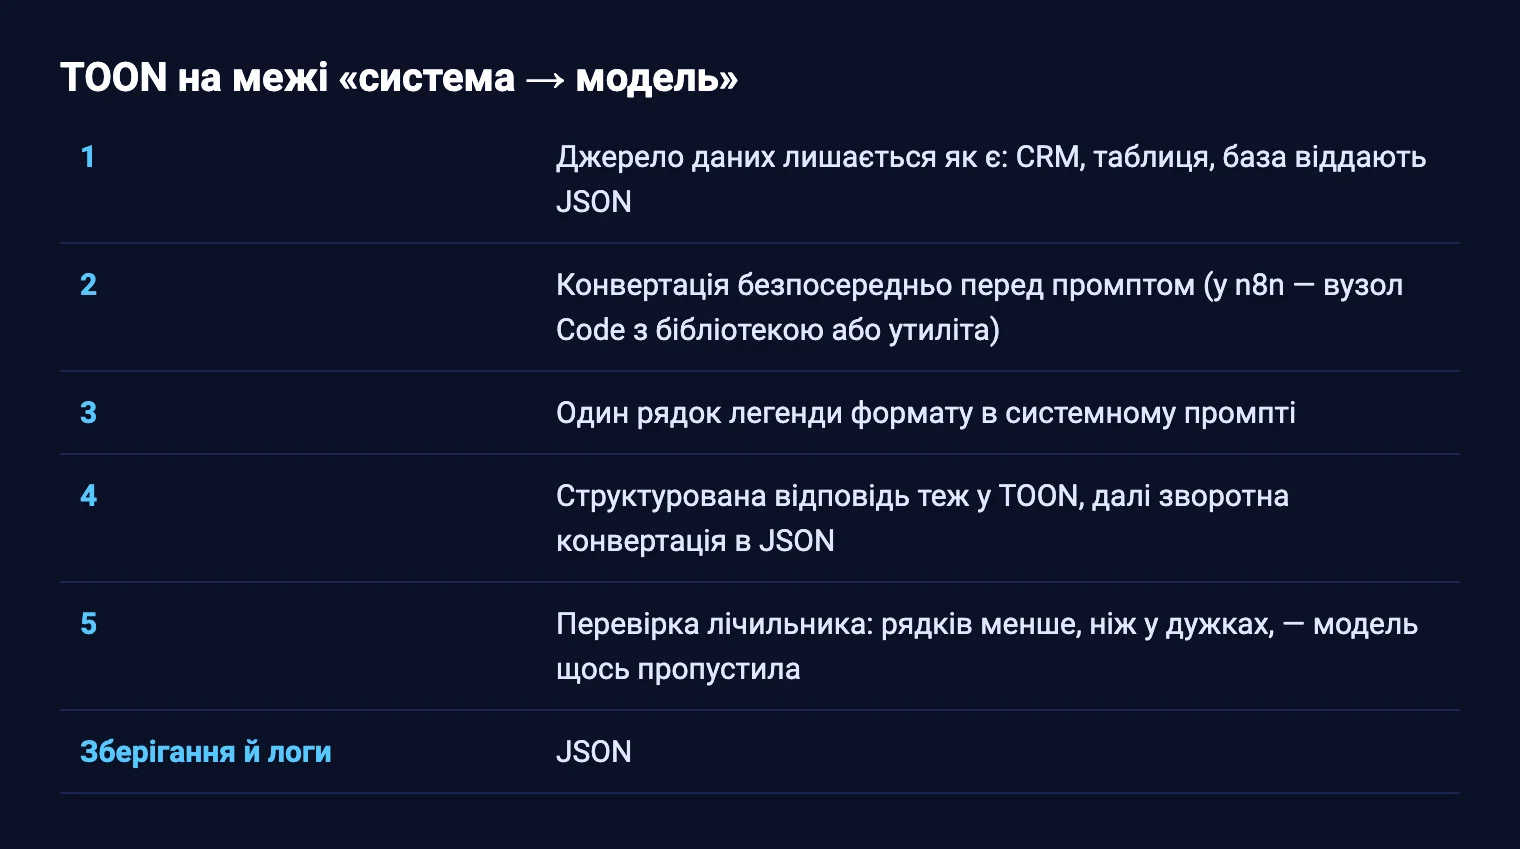
- Лишіть джерело даних як є. CRM, таблиця, база продовжують віддавати JSON. Ви нічого не міняєте в інтеграціях.
- Конвертуйте безпосередньо перед промптом. Окремий крок (у n8n це вузол Code з підключеною бібліотекою або виклик утиліти) бере масив записів і повертає рядок у TOON.
- Дайте моделі одну підказку. Не розраховуйте, що модель «знає» TOON. Один рядок у системному промпті на кшталт «дані нижче у форматі TOON: заголовок містить назву масиву, кількість рядків і перелік полів, далі йдуть значення через кому» знімає більшість непорозумінь.
- Якщо потрібна структурована відповідь, теж просіть TOON. Опишіть очікуваний заголовок (назва масиву й поля), і модель поверне дані в тій самій компактній формі. Далі зворотна конвертація в JSON і звична обробка.
- Перевіряйте лічильник. Кількість у квадратних дужках дає безкоштовний тест цілісності. Рядків менше, ніж заявлено? Значить, модель щось пропустила, і цей випадок треба обробити, а не пропустити далі по ланцюгу.
Окремо про агентні системи. Коли агент А передає результати агенту Б, а той агенту В, кожна передача означає новий промпт із даними. TOON тут окупається найшвидше, бо ті самі дані проходять через модель кілька разів. Але правило те саме: між агентами дані летять у TOON, а зберігаються й логуються в JSON, щоб ви могли їх прочитати й розібрати за потреби.
Якщо ліди приходять із сайту на NEO, джерело вже налаштоване: 6+ форм і вебхуки відправляють заявки в n8n, а звідти в CRM чи таблицю. Крок конвертації в TOON ставите між вебхуком і вузлом із моделлю, інтеграцію з CRM при цьому не чіпаєте.
Помилки, які я бачу найчастіше
- TOON як формат зберігання. Хтось починає писати логи чи відповіді API у TOON. Не треба: інструментів для розбору JSON на порядки більше, а економія токенів у сховищі нікого не цікавить.
- Кома в даних без зміни роздільника. Описи товарів із комами перетворюють таблицю на кашу. Або беріть значення в лапки, або перемикайте роздільник на табуляцію.
- Неоднорідні записи в одній таблиці. Якщо в половини записів немає поля, таблична форма ламається. Або вирівняйте дані заздалегідь, заповнивши порожні значення, або передайте такі записи як вкладені обʼєкти.
- Впровадження без вимірювання. Найпоширеніша. Переписали всі промпти, а рахунок не змінився, бо дані були маленькими. Спочатку міряйте, потім міняйте.
- Відсутність легенди для моделі. Модель отримує незнайомий формат без пояснення і починає «домислювати» структуру. Один рядок легенди прибирає цю проблему.
Якщо ви зараз збираєте автоматизацію з ШІ й не впевнені, де саме витікають токени і час, годинна розмова заощадить вам тижні. На консультації на 60 хвилин я дивлюсь на архітектуру вашого ланцюга й даю план на 30 днів: що конвертувати, що лишити, що виміряти першим.
Коротко
- TOON: формат даних для промптів. Назви полів пишуться один раз, далі йдуть лише значення, а кількість рядків стоїть у заголовку.
- Найбільша економія на однорідних масивах записів: списках лідів, замовлень, товарів, результатів пошуку.
- На одиночних обʼєктах і глибоко вкладених неоднорідних структурах перевага мала або її немає. Це визнає і сама специфікація.
- TOON потрібен лише на межі «система → модель»; у базі, API та логах лишається JSON.
- Моделі потрібна коротка легенда формату в системному промпті, інакше вона домислює структуру.
- Лічильник рядків у заголовку безкоштовно перевіряє, що модель нічого не загубила.
- Перед впровадженням порахуйте токени на своїх реальних даних. Десять хвилин покажуть, чи варто взагалі щось міняти.
Питання, які ставлять найчастіше
Чи розуміють мовні моделі TOON без додаткового навчання?
Так, якщо дати коротке пояснення структури в промпті. Формат навмисно побудований на звичних елементах (заголовок, перелік полів, рядки через роздільник, відступи для вкладеності), тому модель сприймає його як таблицю з підписами. Без легенди результат менш передбачуваний, тому один рядок пояснення я вважаю обовʼязковим.
Чи можна замінити JSON на TOON у всій системі?
Не варто. TOON розвʼязує одну задачу: зменшити кількість токенів у промпті. Для зберігання, обміну між сервісами та логування JSON лишається кращим вибором через екосистему інструментів. Правильна схема: зберігаємо в JSON, конвертуємо в TOON перед промптом, за потреби конвертуємо назад після відповіді.
Що робити, якщо в даних є коми, лапки або переноси рядків?
Або брати такі значення в лапки, як це прийнято в CSV, або змінити роздільник на табуляцію чи вертикальну риску. Специфікація дозволяє обидва варіанти. Для текстових полів із довгими описами зміна роздільника зазвичай зручніша.
Як зрозуміти, скільки я реально заощаджу?
Взяти реальний фрагмент даних із вашого промпту, конвертувати його в TOON і порахувати токени обома варіантами через токенізатор вашого провайдера. Різниця залежить від кількості записів і полів, тому чужі бенчмарки годяться лише як орієнтир.
Чи підходить TOON для відповідей моделі, а не лише для вхідних даних?
Підходить. Якщо описати очікуваний заголовок (назву масиву й перелік полів), модель поверне табличну відповідь у TOON, і ви заощадите токени ще й на виході. Далі її розбирають бібліотекою і перетворюють на звичайний обʼєкт для наступних кроків.