UK
 Ігор Ніколенко
- Вступ: навіщо потрібен llms.txt і кому він допоможе
- Одразу до висновків
- Що таке llms.txt та яку проблему він вирішує
- Структура файлу: обов’язкові та додаткові поля
- Чим llms.txt відрізняється від robots.txt та sitemap.xml
- Як створити llms.txt: покрокова інструкція
- Поширені помилки та як їх уникнути
- Що таке llms-full.txt та чи потрібен він
- Автоматизація та CI/CD: як підтримувати файл актуальним
- Чи варто впроваджувати llms.txt зараз
- Висновок та заклик до дії
Ігор Ніколенко на звʼязку. Коли штучний інтелект перетворюється на твого нового читача, виникає питання: як подати контент так, щоб машині було зрозуміло, де головне, а де другорядне?
Саме для цього й існує llms.txt: простий текстовий файл, який знайомить мовні моделі з вашою веб-сторінкою. У цій статті розберемося, що це за файл, навіщо він потрібен, як його створити та які нюанси варто врахувати. Стаття буде дуже докладною, щоб у вас не залишилось питань.
Вступ: навіщо потрібен llms.txt і кому він допоможе
Мовні моделі, на кшталт ChatGPT чи Claude, дедалі частіше використовують контент із вебу для відповіді на запити користувачів. Проте для них є дві проблеми. По-перше, контекстні вікна у моделей обмежені: вони можуть «прочитати» лише певну кількість символів, тому довгі сторінки розділів доводиться обтинати. По-друге, більшість сучасних сайтів мають складну структуру з HTML‑розміткою, таблицями, скриптами та рекламою, через що машині складно зрозуміти, що насправді важливе. Саме тому зародилася ідея створити окремий файл, який даватиме мовним моделям концентровану інформацію про ваш сайт.
Автор пропозиції, Джеремі Ховард, у вересні 2024 року опублікував на llmstxt.org перший опис стандарту. Він зазначив, що llms.txt розміщується в корені сайту і містить короткий опис проекту, важливі файли та структуровані посилання. Замість того щоб обробляти HTML‑сторінки, агент чи LLM може прочитати цей файл і одразу зрозуміти, які частини сайту є ключовими. За задумом, це має спростити генерацію відповідей і уникнути витрачання ресурсів на зайву інформацію. Експерти відзначають, що llms.txt відрізняється від sitemap: він дає керований список важливого контенту.
Іншими словами, llms.txt не замінює пошукову оптимізацію чи robots.txt. Це інструмент саме для взаємодії з мовними моделями. У нашому матеріалі ви дізнаєтеся, які поля має містити цей файл, як правильно його структуризувати, та як уникати типових помилок.
Одразу до висновків
Якщо у вас немає часу читати весь матеріал, ось коротка витримка:
- llms.txt є текстовим файлом у форматі Markdown, який допомагає мовним моделям швидше зрозуміти структуру вашого сайту та виділити ключові розділи.
- Файл має містити заголовок (назву проекту) у H1, короткий опис у форматі blockquote та структуровані списки посилань із короткими описами. Це робить інформацію зрозумілою для LLM і людей.
- llms.txt доповнює robots.txt і sitemap. Його мета: підкреслити цінний контент, без обмеження доступу і без переліку всіх сторінок.
- Для створення файлу достатньо текстового редактора і базових знань Markdown. Важливо правильно розташувати його на сервері: зазвичай це корінь сайту (yourdomain.com/llms.txt).
- Підтримка стандарту поки що обмежена: великі AI‑провайдери не підтвердили офіційно, що читають llms.txt. Утім, деякі компанії (наприклад, Anthropic) вже публікують такі файли, і цікавість до них зростає.
Далі розглянемо все докладніше, від історії виникнення до покрокових порад зі створення та автоматизації.
Що таке llms.txt та яку проблему він вирішує
На відміну від пошукових роботів, які сканують HTML та створюють індекс на основі ключових слів і посилань, AI‑агенти опрацьовують текст у межах обмеженого контексту. Вони не здатні одразу зрозуміти, які сторінки важливіші за інші. Саме це намагається виправити llms.txt.
Основна мета формату: підвищити ефективність взаємодії AI‑агентів із вашим сайтом. У статті на порталі Parallel.ai пояснюють, що файл виконує роль «карти» для мовних моделей: він містить назву сайту, короткий опис та список пріоритетних сторінок із поясненнями, чому вони важливі. Таким чином, агент може швидко зрозуміти, де шукати потрібну інформацію, не витрачаючи обчислювальні ресурси на вторинні сторінки.
Стандарт також допомагає вирішити проблему «захаращеності» сучасних веб‑ресурсів. За даними блогу Semrush, AI‑краулери часто стикаються з двома викликами: 1) Сучасні сайти важко читати через складну розмітку й динамічний контент.2) На більшості сайтів занадто багато інформації, і агент не знає, на чому зосередитись. llms.txt пропонує зрозумілу, компактну структуру, яка допомагає обійти ці проблеми. Крім того, файл може знизити обчислювальні витрати: LLM не буде марнувати час на непотрібний контент.
Звідки береться назва? LLMs.txt буквально поєднує «Large Language Models» та .txt. Автори натякають на аналогію з robots.txt або sitemap.xml. Однак головна відмінність полягає в тому, що llms.txt призначений саме для мовних моделей і, на відміну від robots.txt, не обмежує доступ. Навпаки, він рекомендує, що читати. Він також не дублює sitemap.xml, який перераховує всі сторінки; натомість llms.txt підкреслює найважливіші.
Структура файлу: обов’язкові та додаткові поля
Щоб файл коректно сприймали агенти, його структура повинна бути стандартизованою. Офіційний опис на llmstxt.org рекомендує таку послідовність:
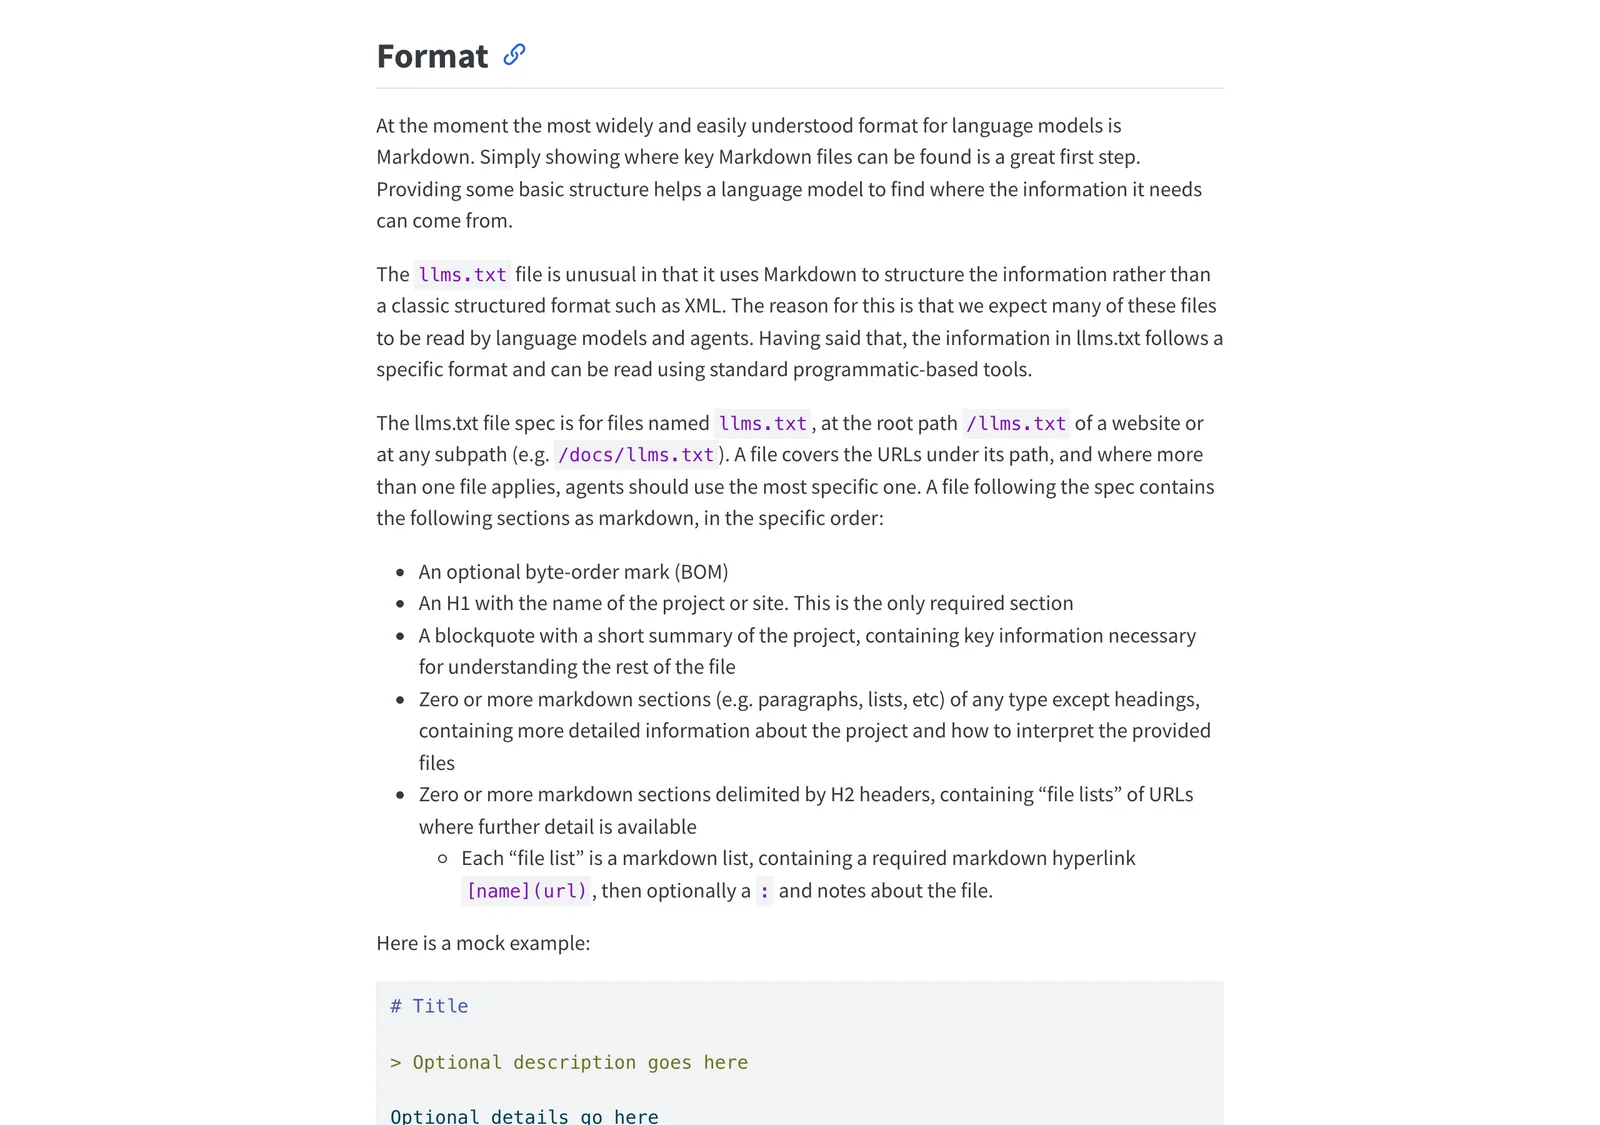
- Заголовок (H1). Це назва вашого проекту або сайту. Заголовок обов’язковий і має бути першим рядком файлу.
- Короткий опис у blockquote. Після заголовка йде короткий опис проекту, буквально 1‑3 речення, що передають сутність ресурсу. Він допомагає моделі швидко зрозуміти, про що йдеться.
- Деталі та примітки. Далі можна додати декілька абзаців або списків із важливими уточненнями. Наприклад, які сервіси ви підтримуєте, що відрізняє ваш продукт, чи є обмеження. Це аналог розділу «Important notes» у прикладі з FastHTML.
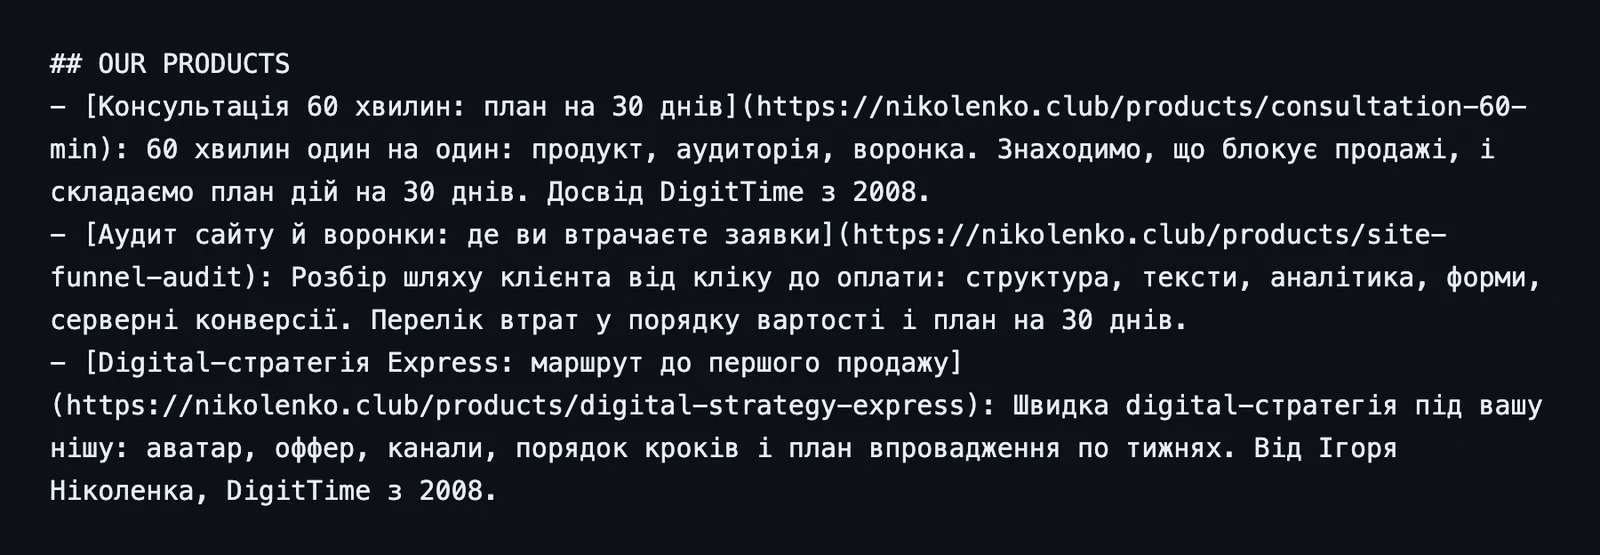
- Розділи з файлами (H2). Після приміток йдуть розділи з переліком файлів або сторінок. Назви розділів оформлюють заголовками H2, під ними розміщують марковані списки посилань. Кожен пункт повинен містити:
- Назву ресурсу у квадратних дужках;
- URL‑адресу в дужках;
- короткий опис після двокрапки. Коментар пояснює, чому ця сторінка важлива.
- Опціональний розділ «Optional». Якщо певні матеріали не є критичними, їх можна згрупувати в секції «Optional». Це підказка агенту, що ці ресурси можна пропустити за потреби.
У статті Parallel.ai також перераховані «обов’язкові елементи» формату: назва сайту, опис та структурований список URL. Додатково, за бажанням, можна включити контактну інформацію, посилання на API‑документацію, номер версії чи дату оновлення. Така інформація допоможе агентам зрозуміти, як взаємодіяти з вашим сервісом, та перевірити актуальність даних.
Важливою перевагою є те, що формат базується на Markdown, тому його легко писати та читати. Стандарт рекомендує використовувати базові елементи: заголовки (#, ##), blockquote (>), марковані списки (-) та посилання у форматі [текст](url). За потреби, якщо ваш ресурс дуже великий, можна використовувати заголовки H3, таблиці чи навіть код-блоки; головне: зберігати читабельність.
Навіть якщо ваш сайт має сотні сторінок, не потрібно включати їх усі в llms.txt. На думку експертів, файл має містити відносно короткий перелік найважливіших сторінок, зазвичай 10‑15 позицій. Якщо у вас є великий розділ для LLM, краще створити окремий файл llms-full.txt (про нього далі).
Чим llms.txt відрізняється від robots.txt та sitemap.xml
На перший погляд може здатися, що llms.txt дублює функції robots.txt та sitemap.xml. Проте, за словами розробників стандарту, роль кожного з цих файлів різна:
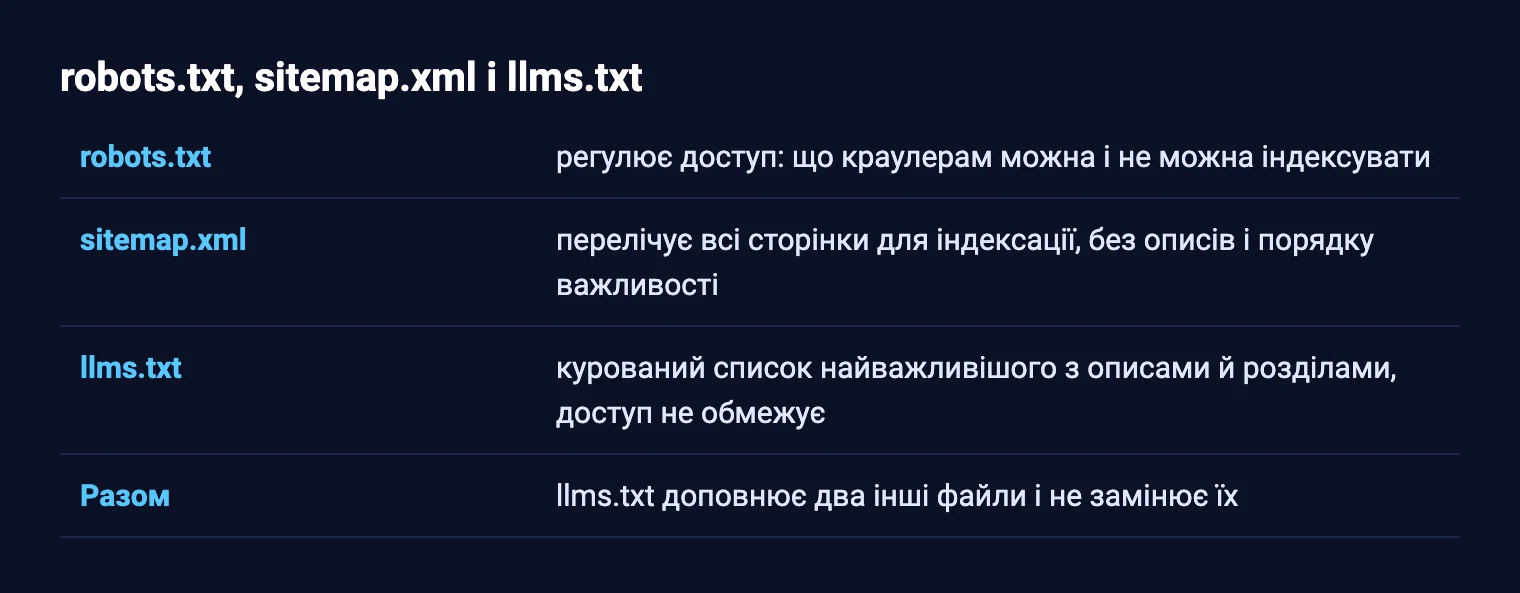
- robots.txt повідомляє пошуковим краулерам, що можна або не можна індексувати на сайті. Це файл сервера, який регулює доступ. llms.txt не встановлює обмежень, а лише рекомендує, що варто читати.
- sitemap.xml перелічує всі доступні сторінки для індексації. У ньому немає описів або порядку важливості, а сам список може бути дуже великим.
- llms.txt додає іншу цінність: надає курований список найбільш важливих матеріалів, з описами та поділом на розділи. Він допомагає AI‑агентам зрозуміти структуру сайту та визначити пріоритет, тоді як sitemap перелічує все підряд.
У статті Parallel.ai llms.txt називають інструментом «інклюзії»: він не обмежує доступ, а запрошує агента читати певний контент. Роботи, які поважають robots.txt, можуть пропустити заборонені частини сайту. А llms.txt підказує, що важливо, і дає змогу AI‑сервісам працювати ефективніше.
Як створити llms.txt: покрокова інструкція
Створити llms.txt може будь‑який власник сайту чи розробник. Ось детальна інструкція на основі рекомендацій з статей на Semrush та Parallel.ai:
- Визначте, які сторінки включити. Перший крок: проаналізувати свій сайт і вибрати ті сторінки, які ви хочете порекомендувати AI‑агентам. Семруш радить зосередитися на продуктах чи послугах, актуальних статтях блогу, сторінці цін, інформації «Про нас» та «Контакти». Запитайте себе: «Якщо агент зможе прочитати лише десять сторінок, які дадуть найкраще уявлення про мій бізнес?».
Створіть файл у Markdown. Відкрийте будь-який текстовий редактор (Notepad, VS Code, Sublime). Назвіть файл llms.txt і збережіть його. На початку напишіть заголовок із назвою проекту, нижче короткий опис у blockquote. Потім додайте список секцій з посиланнями. Приклад структури виглядає так:
# MySite
> Короткий опис вашого проєкту у двох реченнях

Важливі примітки:
- Пункт 1
- Пункт 2
- Пункт 3

## Продукти
- [Продукт A](https://example.com/a): Короткий опис основних переваг
- [Продукт B](https://example.com/b): Короткий опис

## Блог
- [Стаття 1](https://example.com/blog-1): Про що вона і чому корисна
- [Стаття 2](https://example.com/blog-2): …

## Компанія
- [Про нас](https://example.com/about): Інформація про команду
- [Ціни](https://example.com/pricing): Огляд тарифів
- [Контакти](https://example.com/contact): Як зв’язатися
Такий формат чіткий для людей і машин: використовуйте марковані списки та короткі описи, щоб пояснити значення кожної сторінки.
- Розмістіть файл у корені сайту. Збережений файл потрібно завантажити на сервер. Якщо файл описує весь сайт, розміщуйте його в кореневій директорії (public_html), і він буде доступний за адресою https://yourdomain.com/llms.txt.
Якщо ви створюєте файл лише для документації, завантажте його у відповідний підрозділ (наприклад, https://docs.yourdomain.com/llms.txt). Якщо ви використовуєте CMS або генератор статичних сайтів (Docusaurus, VitePress), розміщуйте файл у папці, яка виводиться на корінь при збірці.
- Валідуйте структуру. Перш ніж публікувати файл, перевірте його коректність за допомогою онлайн‑валідаторів. Наприклад, сервіс llmtext.com сканує файл, перевіряє форматування та доступність посилань. Це допоможе уникнути помилок (неправильних посилань, відсутніх описів) і переконатися, що файл читається як людиною, так і машиною.
- Регулярно оновлюйте. Цей файл не пишуть один раз на роки. Коли ви публікуєте нові статті чи розділи, або коли змінюється структура сайту, оновлюйте файл. Експерти радять синхронізувати оновлення з вашим редакційним календарем чи релізами продуктів, щоб файл залишався актуальним. Використовуйте систему контролю версій (Git), щоб відстежувати зміни та мати історію редагувань.
Зауважте, що створення файлу може зайняти всього кілька годин, а користь потенційно проявиться в майбутньому: ваш контент краще виглядатиме в AI‑відповідях. Навіть якщо зараз формат не офіційний, він може стати стандартом у найближчі роки.
Якщо сайт працює на NEO, llms.txt входить у стандартну SEO-частину платформи разом зі Schema.org і чистою розміткою. Ваша робота тоді зводиться до головного: вибрати ключові сторінки й написати до них зрозумілі описи.
Поширені помилки та як їх уникнути
За даними статті Parallel.ai, багато компаній, які вперше створюють llms.txt, допускають типові помилки.
Ось три основні:
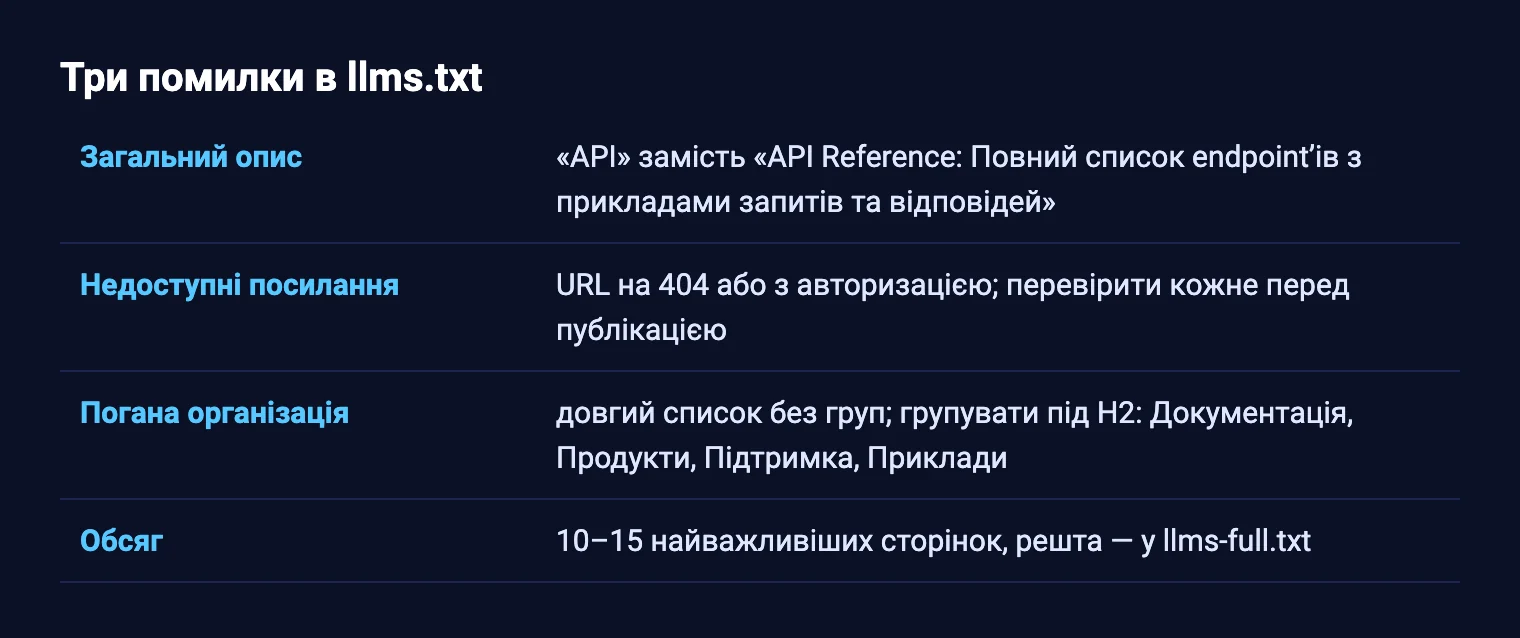
- Неповні або загальні описи. Вказати просто «Документація» чи «Блог» недостатньо. Кожен пункт має містити пояснення, чому сторінка важлива, які питання вирішує або яку користь дає. Наприклад: «API Reference: Повний список endpoint’ів з прикладами запитів та відповідей» замість просто «API».
- Неправильні чи недоступні посилання. URL, які ведуть на 404 або вимагають авторизації, роблять файл марним. Перед публікацією перевіряйте кожне посилання: чи воно відкривається без помилок, чи містить потрібний контент.
- Погана організація. Якщо список посилань дуже довгий і без логічної групи, моделі буде складно зрозуміти, де який розділ. Використовуйте заголовки H2 для групування за темами (Документація, Продукти, Підтримка, Приклади тощо).
Щоб уникнути цих помилок, дотримуйтеся принципів: чіткість, структурованість та актуальність. Пам’ятайте, що файл читають і люди: ваші партнери чи користувачі також можуть відкрити його, щоб швидко знайти корисну інформацію.
Що таке llms-full.txt та чи потрібен він
Якщо llms.txt є коротким гідом для мовних моделей, то llms-full.txt працює як «повний довідник». У статті Parallel.ai вказано, що основний файл містить лише пріоритетні сторінки, а llms-full.txt може включати всю документацію або великий обсяг контенту. Зазвичай його використовують у великих проектах, де потрібно надати максимум інформації для агентів. За бажанням, ви можете створити обидва файли: основний для швидкого ознайомлення та повний для детальної інформації.
У документації Mintlify описано, що llms-full.txt об’єднує всю документацію сайту і може бути автоматично згенерований для проектів, що використовують цей сервіс. У більшості випадків достатньо обмежитись базовим llms.txt. Якщо ваш сайт складається з декількох величезних розділів (наприклад, API‑довідники, численні посібники), а ваші користувачі або партнери потребують повного доступу до всього, можна додати llms-full.txt.
Автоматизація та CI/CD: як підтримувати файл актуальним
Щоб файл не застарів, важливо автоматизувати його оновлення. У статті Parallel.ai радять інтегрувати генерацію llms.txt у ваші CI/CD‑пайплайни. Наприклад, якщо ви використовуєте статичний генератор або систему управління контентом з фронтматером (frontmatter), можна написати скрипт, який:
- Сканує структуру сайту, збирає назви сторінок і їхні описи із frontmatter;
- Генерує структуру з заголовком, описом та секціями;
- Розміщує згенерований файл у кореневій папці при кожному деплої;
- При необхідності створює llms-full.txt з усіма матеріалами.
Такий підхід дозволяє вам не думати про оновлення вручну: файл завжди відображатиме актуальний стан вашого контенту. Особливо це корисно для великих технічних проектів чи документаційних сайтів.
Для невеликих проектів, де зміни контенту відбуваються рідко, автоматизація не є обов’язковою. Достатньо встановити нагадування або включити оновлення файлу до процесу підготовки публікацій.
Чи варто впроваджувати llms.txt зараз
Запитання «Навіщо мені це потрібно?» закономірне. Статті на Semrush та інших ресурсах зазначають, що поки стандарт не є офіційним і не підтримується великими AI‑компаніями. Більше того, пошукові системи не використовують llms.txt для ранжування, тому він не впливає на SEO безпосередньо. Проте є кілька аргументів на користь експерименту:
- Низький поріг входу. Створити файл нескладно. Вам потрібно лише кілька годин, щоб зібрати посилання та написати опис. Навіть якщо формат не стане мейнстрімом, ви витратите мінімум ресурсів.
- Потенційні плюси у майбутньому. Якщо llms.txt стане стандартом, ранні користувачі отримають конкурентну перевагу: їхній контент буде краще розумітися агентами, що може покращити видимість у відповідях AI.
- Прозорість для партнерів та клієнтів. Файл може стати корисним навіть для людей: постачальники, партнери чи журналісти можуть швидко зрозуміти структуру вашого сайту та знайти потрібні ресурси.
- Підвищення ефективності індексації. Навіть якщо великі LLM поки що не підтримують llms.txt, деякі інструменти та платформи (наприклад, Parallel, Anthropic) вже працюють із ним. Якщо ви використовуєте ці сервіси, файл може покращити результати.
Водночас, якщо у вас обмежені ресурси та багато інших завдань, впровадження llms.txt може почекати. Пам’ятайте: цей файл не гарантовано змінить відвідуваність або продажі, проте він показує ваш проактивний підхід до майбутніх стандартів. Рішення залежить від вашої стратегії, цілей та аудиторії.
Висновок та заклик до дії
llms.txt є новою ініціативою, покликаною зробити ваш сайт зрозумілішим для мовних моделей. Це простий текстовий файл із зрозумілою структурою: заголовок, короткий опис, список важливих сторінок і, за потреби, додаткові примітки. Він призначений для того, щоб виділити найціннішу інформацію й економити ресурси AI‑системи. Формат доповнює robots.txt і sitemap.xml: доступ він не обмежує, його задача показати пріоритети.
Ми з’ясували, що llms.txt може бути корисним як для AI‑агентів, так і для людей, які хочуть швидко орієнтуватися на сайті. Проте офіційної підтримки від великих AI‑компаній поки немає, тому впровадження лишається добровільним. Якщо вам цікаво експериментувати й бути серед перших, хто адаптується до нових стандартів, спробуйте створити llms.txt на своєму сайті та поділитися своїм досвідом у коментарях або соцмережах.
💡 Дія для вас: складіть список 10 ключових сторінок вашого сайту, напишіть короткі описи та створіть власний llms.txt. Потім перевірте, чи файл доступний за адресою yourdomain.com/llms.txt, і протестуйте його на онлайн‑валідаторі. Пишіть у коментарях, які результати ви отримали: ваш досвід може допомогти іншим!
А якщо ви хочете ще більше поглибити свої знання про digital‑маркетинг та автоматизацію, підписуйтесь у мій блог у Telegram @nikolenkoclub та за формою у підвалі сайту та слідкуйте за новими статтями. Разом навчимося бути на крок попереду! 🚀